WR / AI LAB

MULTIMODAL · DATA & POST-TRAINING

用数据和评测让模型真正学会表达

从语音情感、视觉数据到结构化推理,我关注数据边界、训练策略和可复现评测,而不是只展示一张看起来不错的样片。

Speech / Vision / ReasoningVoice Story ↗Cats dataset ↗
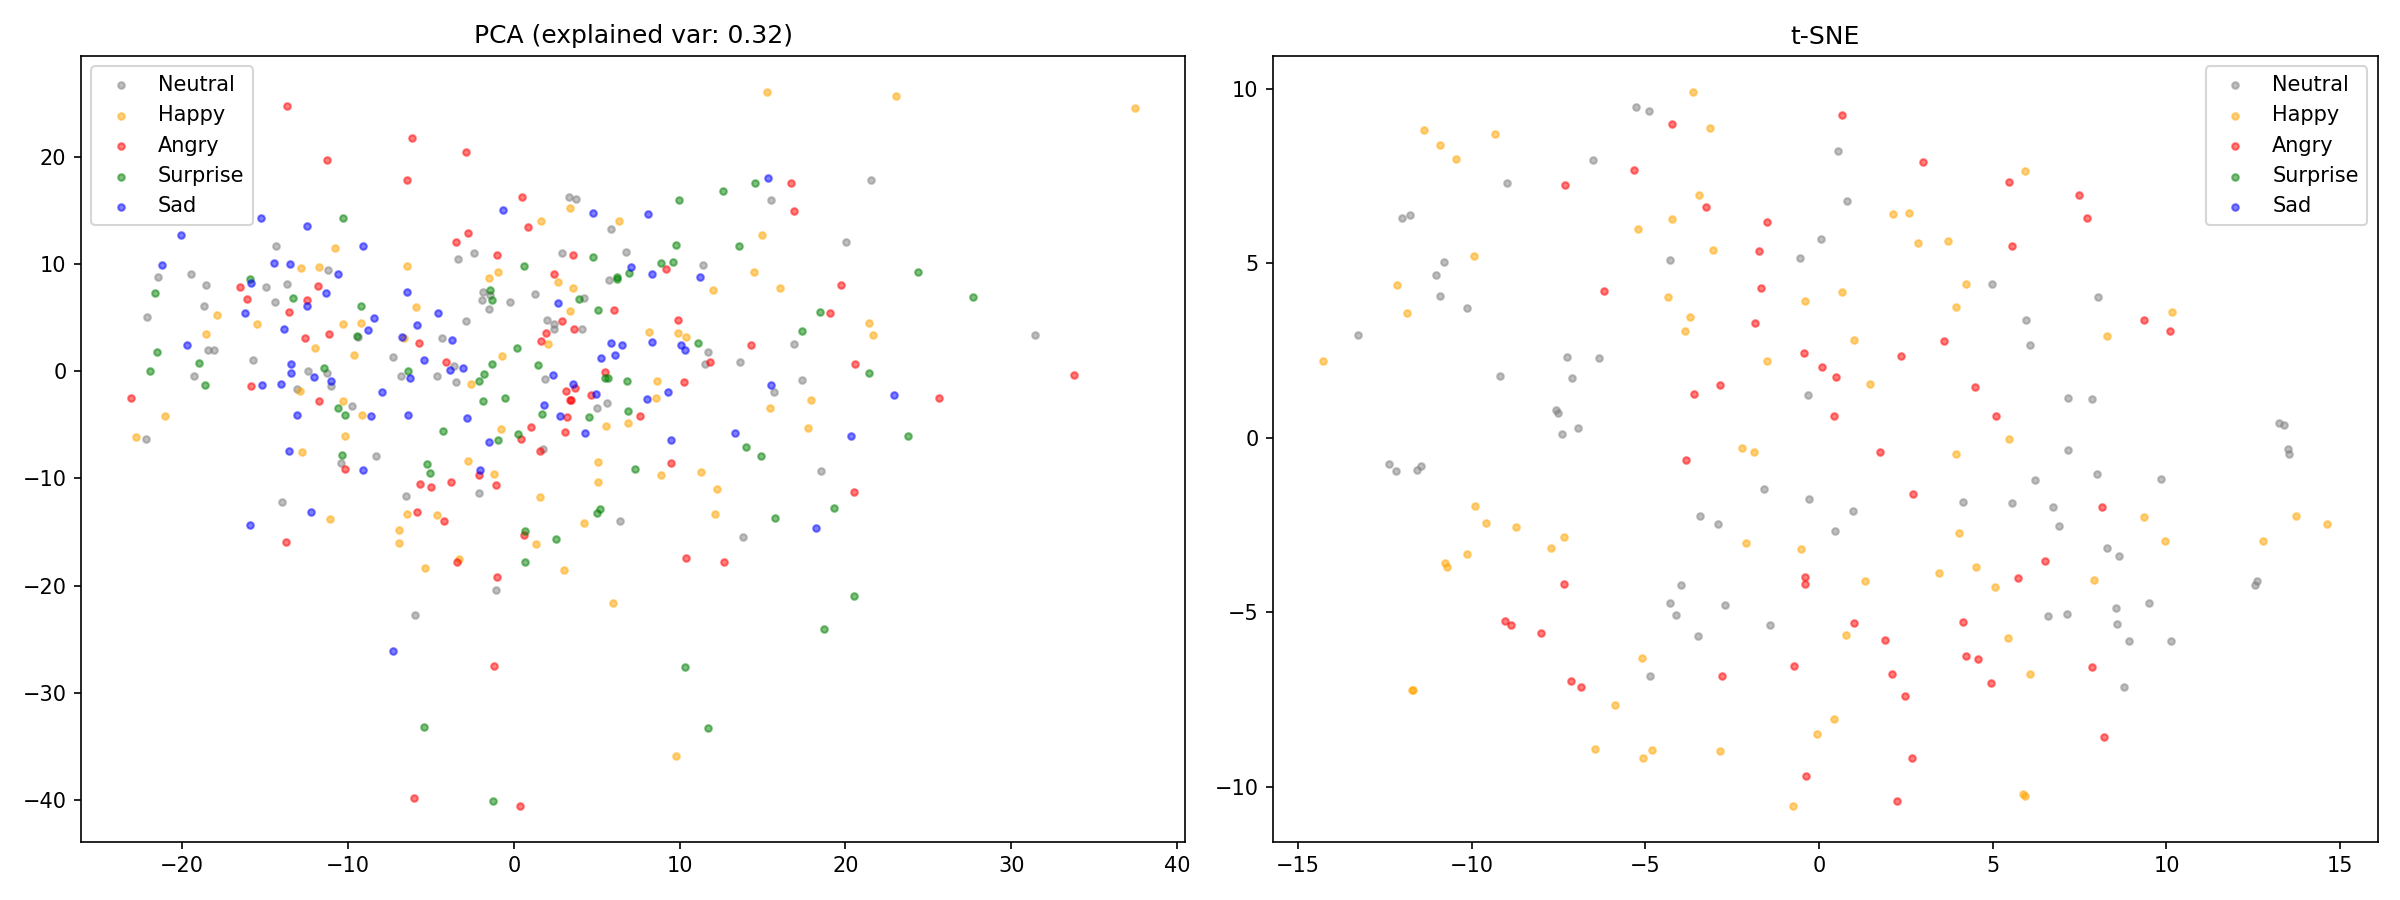
Voice Story 情绪表征可视化
数据先于训练记录来源、规模、标签、划分和授权边界,避免把样本当结论。
训练有可比较基线SFT、LoRA、Prompt 和数据增强都要对应实验记录。
评测覆盖失败CER、SECS、F0、NISQA、混淆矩阵和 bad case 一起看。

FLAGSHIP RESEARCH

语音系统的难点不是“能合成”,而是知道什么时候失稳。

当前公开的是研究系统和实验结论;完整 GPU 推理不在轻量网页服务器上运行。

01 / VOICE STORY

用可懂度、相似度和韵律把情感语音拆开测。

我搭建 source → preprocess → dataset → synthesis → evaluation 管线,用 CosyVoice 3 进行合成,把 Demucs、VAD、FunASR 和评测 worker 与编排层分离。

评测轴CER 看可懂度,SECS 看 speaker similarity,F0 RMSE 看韵律稳定性,另有 MOS/NISQA 与 RTF。
失败结论长文本 400→800 字出现明显退化,产品策略是切成 300–400 字段,而不是继续堆 prompt。

Experiment axes

Referencesource + speaker profile
Prosodyemotion + style spec
SynthesisCosyVoice worker
EvaluationCER / SECS / F0

DATA & EVALUATION

把实验记录写成别人可以复核的证据。

不把小样本准确率包装成通用能力;当前页面只展示已有实验范围。

已记录的实验

实验观察
720 条情感语音8 speakers × 5 emotions × 6 texts × 3 seeds
Voice emotion probe360 WavLM embeddings;linear probe 65.8%
长文本稳定性400→800 字出现质量相变;更长文本大幅退化
数据结论Happy 较易分;Sad / Neutral 边界更模糊
GPU 时间 / 训练成本measurement pending

后续要补的证据

  • 公开 train/validation/test 划分和类别分布。
  • 增加 LoRA/SFT 与 zero-shot 的同条件基线。
  • 补混淆矩阵、人工 MOS 和跨说话人泛化。
  • 记录模型导出、推理 RTF 和数据授权清单。

DATASET & REASONING

另外两条研究支线。

回到可运行的 Agent 系统。

Agent 作品集 ↗GitHub ↗